SPEC // 01
ATTENTION
MLA 潜在注意力机制
低秩联合压缩技术大幅降低 KV Cache 显存占用,保障数十轮长对话依然响应迅速。
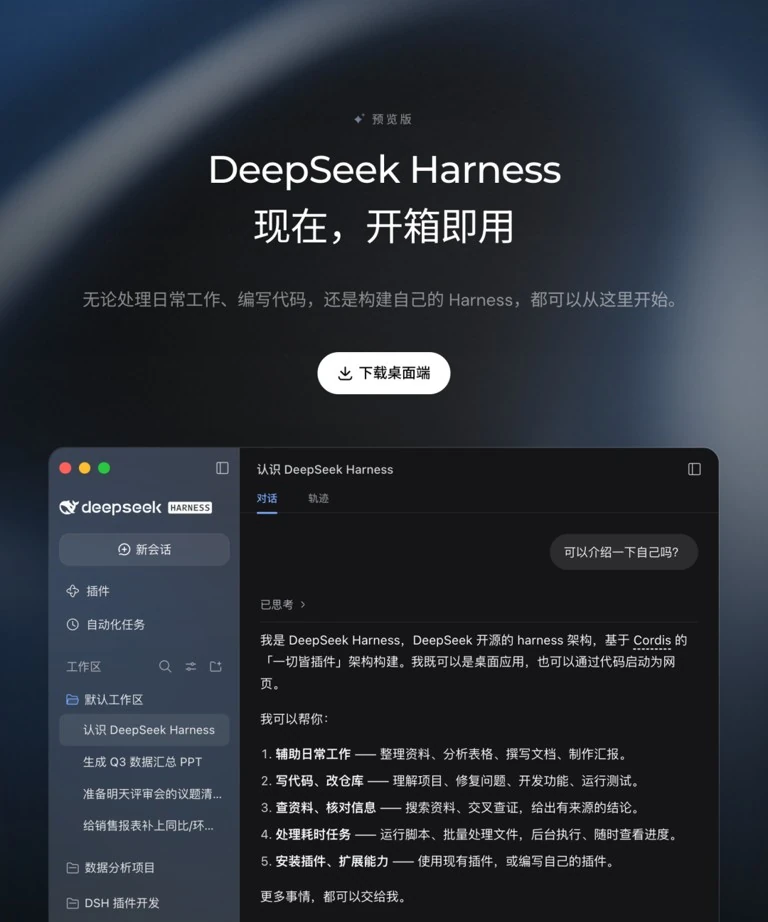
首屏率先点出 DeepSeek Harness 标准双盲沙箱验证。探索者可在 DeepSeek网页版入口 免安装验证前沿模型最新特性,在 DeepSeek api开放平台 调度千万级并发推理,全面见证可复现的因果闭环。
章题窄幅居中呈现,底层注意力低秩压缩与纯强化学习自发推演支撑高可靠长对话。
低秩联合压缩技术大幅降低 KV Cache 显存占用,保障数十轮长对话依然响应迅速。
完全抛弃人工监督微调诱导,通过自博弈强化学习激发长篇反思与自我纠错能力。
细粒度专家动态稀疏路由,在庞大参数容量与单 Token 计算功耗间实现极致平衡。
单次请求容纳整部专著或海量源码库,支持持续深入长对话而不发生前文记忆遗忘。
深入复杂多变业务场景,将长对话多轮追问转化为严密可执行的生产力结果。
自动扫描工程深层耦合,输出符合函数式规范的重组建议,并生成单元测试断言用例。
ENGINEERING // 01针对国际数学奥林匹克级别的离散几何与数论命题,展开严格递进的公理化证明链条。
MATHEMATICS // 02在 128K 超长窗口内交叉审视多国商业收购条款,精准标识排他条款潜在合规冲突。
JURISPRUDENCE // 03整合宏观行研与多因子量化指标,自动生成矢量化回测代码并估算最大回撤阈值。
QUANTITATIVE // 04作为自主智能体核心大脑分解长路径规划,调度外部工具并在发生调用异常时自主修复。
AUTONOMOUS // 05开源全量模型权重,支持在主流国产硬件环境中实现高效本地量化与物理隔离部署。
DEPLOYMENT // 06清晰透明的阶梯资费与上下文规格,横向机架布局一览无余。
REASONING // FULL SCALE
GENERAL // HIGH THROUGHPUT
ENGINEERING // SPECIALIZED
先讲怎么接:全面兼容行业通用标准协议,快速接入长对话业务流。
登录开放平台控制台,秒级签发 Bearer 认证密钥,针对长对话业务设置精细化调用预算。
直接沿用官方 OpenAI SDK,配置 baseURL 为 api.deepseek.com 即可无缝切换底层算力底座。
规整固化 System Prompt 与长对话历史背景,系统自动激活硬盘级缓存减免,降低 80% 输入开销。
后文详尽展开 DeepSeek网页版入口:覆盖免登录轻量网页交互、工业级 API 与离线测试沙箱。
免去本地安装与繁杂配置,浏览器直达 R1 满血版显式思维链,先体验网页再进入长对话。
提供毫秒级流式推送、函数调用与低资费前缀缓存,为企业级核心应用赋能智能底座。
全量开放测试集与判分脚本,支持企业自建评测集实施双盲客观复现与事实校验。
章题居中对齐,用硬核数字丈量长对话自洽精度与工业级生产可行性。
首屏点出 Harness,尾段在此形成因果闭环:所有逻辑主张终结于双盲复现。
官方评测沙箱涵盖 AIME 2024、MATH-500、LiveCodeBench 等权威测试集,输入及判分脚本完全开源,杜绝私有黑盒刷榜。
内置思维链完备性语法断言器,自动对长对话中的假设提出、公式变换与最终结论判定进行逐步因果验算,确保证明逻辑环环相扣。
针对长对话连续追问、前缀缓存与网页免安装体验的透明解答。
及时通报长对话上下文调度优化、开源权重发布与基准测评进展。
以 64 Tokens 单元自动固化系统提示词前缀,大幅削减长对话重复请求计算损耗与网络首包时间。
单次输入可容纳整本教材或完整专著代码库,长链因果分析能力显著强化。
引入跨目录补丁语法树验证与 Agent 递归调用完整性约束,全面开源提供评测脚本。